数据集(Datasets)
数据集是输入和预期输出的集合,用于测试你的应用。基于 UI 和基于 SDK 的实验都支持 Langfuse 数据集。
Langfuse 数据集视图
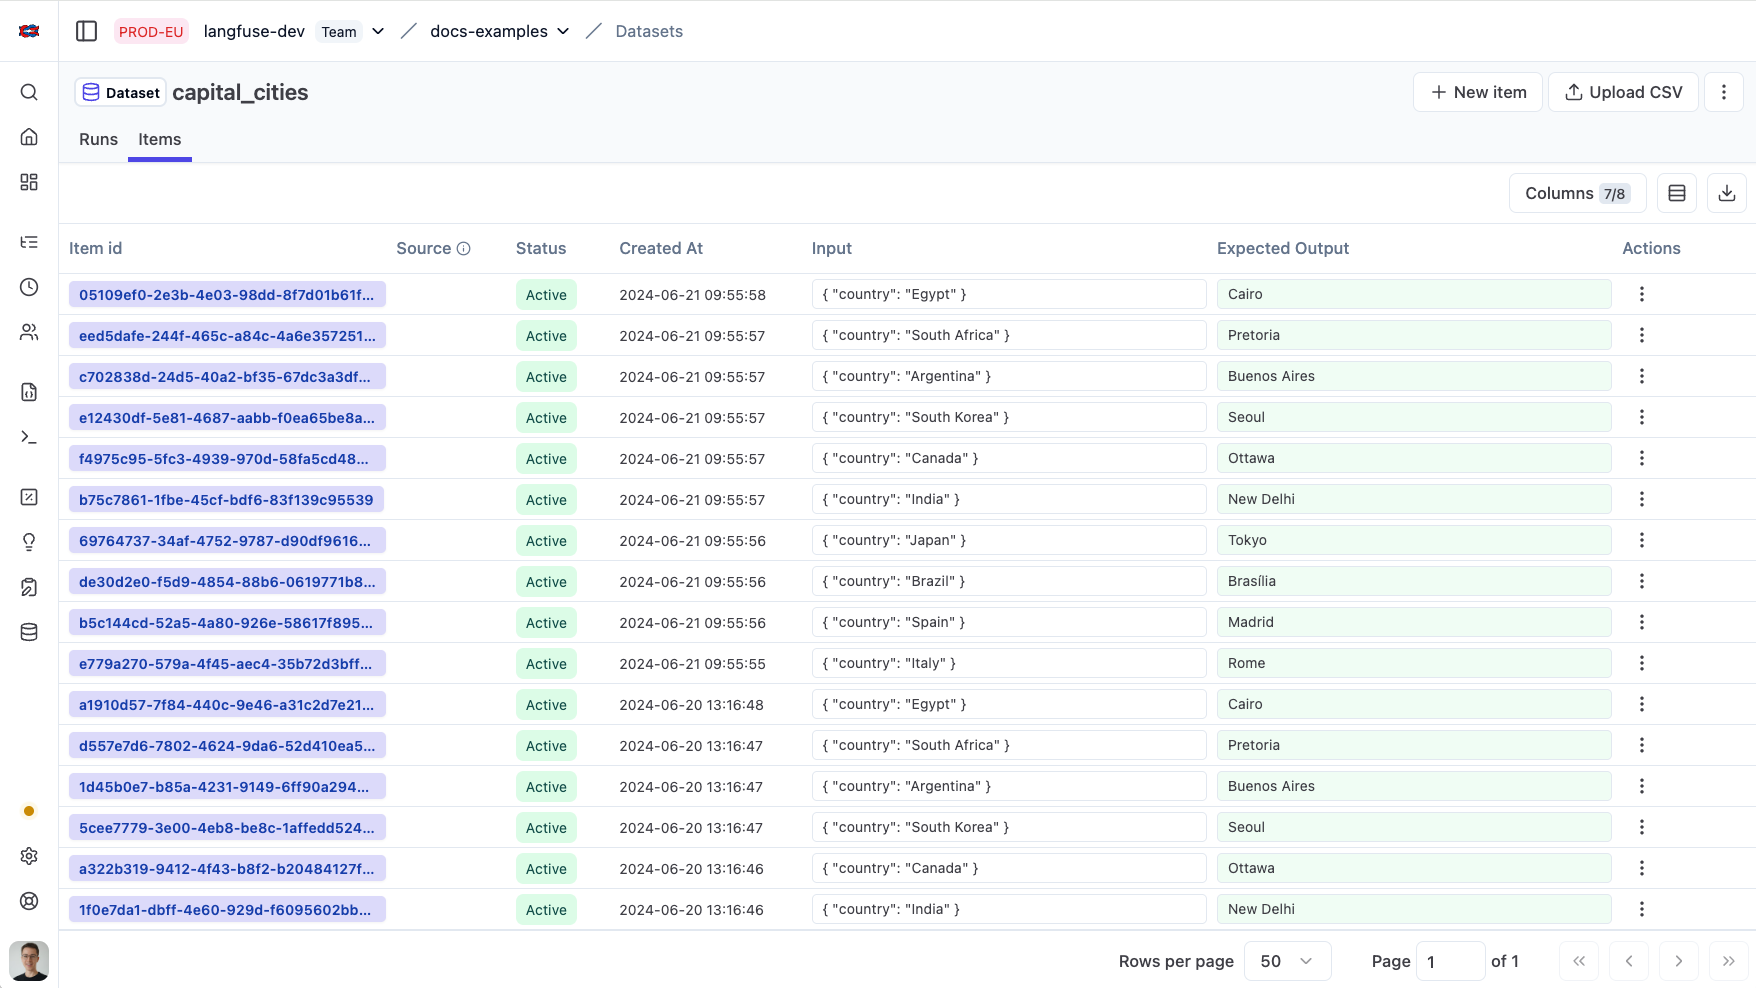
为什么使用数据集?
- 用真实的生产 traces 为你的应用创建测试用例
- 与团队协作创建和收集数据集条目
- 为测试数据提供唯一的可信来源(single source of truth)
开始使用
你可以在 Langfuse UI 中创建数据集并添加条目,也可以通过 SDK 以编程方式创建。
多模态数据集条目
数据集条目的 input、expectedOutput 和 metadata 字段可以包含媒体附件,如图像、音频、视频、文档和其他文件。你可以在创建或编辑条目时从 Langfuse UI 添加媒体,也可以通过 Python 和 JS/TS SDK 用 LangfuseMedia 上传媒体。
多模态数据集支持基于 SDK 的实验,需要 Python SDK
>= 4.10.0和 JS/TS SDK@langfuse/client >= 5.6.0。基于 UI 的实验尚不支持带媒体附件的数据集条目。
在 UI 中,打开一个数据集条目,使用附件按钮、拖放或粘贴文件到 input、expectedOutput 或 metadata 编辑器中。
在 SDK 中,创建数据集条目之前先用 LangfuseMedia 包装媒体。SDK 会上传媒体,在数据集条目中存储引用,Langfuse UI 会渲染附件预览。
from langfuse import get_client
from langfuse.media import LangfuseMedia

langfuse = get_client()

langfuse.create_dataset_item(
    dataset_name="visual-qa",
    input={
        "question": "What is shown in this image?",
        "image": LangfuseMedia(
            file_path="./example.jpg",
            content_type="image/jpeg",
        ),
    },
    expected_output={"label": "invoice"},
)

dataset = langfuse.get_dataset("visual-qa")
import { LangfuseClient, LangfuseMedia } from "@langfuse/client";
import fs from "node:fs";

const langfuse = new LangfuseClient();

await langfuse.dataset.createItem({
  datasetName: "visual-qa",
  input: {
    question: "What is shown in this image?",
    image: new LangfuseMedia({
      source: "bytes",
      contentBytes: fs.readFileSync("./example.jpg"),
      contentType: "image/jpeg",
    }),
  },
  expectedOutput: { label: "invoice" },
});

const dataset = await langfuse.dataset.get("visual-qa");
关于在实验中使用多模态条目,参见通过 SDK 做实验。
CSV 导入仅适用于文本和结构化 JSON 数据集条目。多模态数据集条目请使用 UI 条目编辑器或 SDK。
数据集文件夹
数据集可以组织到虚拟文件夹中,将服务于相似用例的数据集归组。
要创建文件夹,在数据集名称中添加斜杠(/)。UI 会自动把以 / 结尾的每个片段显示为文件夹。
在文件夹中创建和获取数据集
使用 Langfuse UI 或 SDK,通过在数据集名称中添加斜杠(/)来在文件夹中创建和获取数据集。
dataset_name = "evaluation/qa-dataset"

# When creating a dataset, use the full dataset name
langfuse.create_dataset(
    name=dataset_name,
)

# When fetching a dataset in a folder, use the full dataset name
langfuse.get_dataset(
    name=dataset_name
)
这会在名为 evaluation 的文件夹中创建并获取名为 qa-dataset 的数据集。完整的数据集名称仍为 evaluation/qa-dataset。
import { LangfuseClient } from "@langfuse/client";

const langfuse = new LangfuseClient();

const datasetName = "evaluation/qa-dataset";
const encodedName = encodeURIComponent(datasetName); // "evaluation%2Fqa-dataset"

// When creating a dataset, use the full dataset name
await langfuse.dataset.create(datasetName);

// When fetching a dataset in a folder, use the encoded name
await langfuse.dataset.get(encodedName);
这会在名为 evaluation 的文件夹中创建并获取名为 qa-dataset 的数据集。完整的数据集名称仍为 evaluation/qa-dataset。
在 UI 中,创建数据集并在名称字段中使用斜杠(/)将其组织到文件夹中。通过导航到该文件夹、点击文件夹名称,再点击列表中的数据集名称来获取它。
URL 编码:在 API 或 JS/TS SDK 中把带斜杠的数据集名称用作路径参数时,请使用 URL 编码。例如在 TypeScript 中:
encodeURIComponent(name)。
版本控制
要通过 Langfuse UI 访问数据集版本,请导航到:Datasets > 进入特定数据集 > 选择 Items 标签页。在此页面你可以切换版本视图。
对数据集条目的每次 add、update、delete 或 archive 都会产生一个新的数据集版本。版本使用时间戳追踪随时间的变化。
GET API 默认在查询时返回最新版本。你可以使用 version 参数获取特定版本时间戳的数据集。
版本控制仅适用于数据集条目,不适用于数据集 schema。数据集 schema 的更改不会创建新版本。
获取特定版本的数据集
你可以通过提供版本时间戳,检索数据集在某个特定时间点的状态。这只会返回该时间戳存在的条目。
from langfuse import get_client
from datetime import datetime, timedelta

langfuse = get_client()

# Capture dataset state as of 2025-12-15 at 06:30:00 UTC
version_timestamp = datetime(2025, 12, 15, 6, 30, 0, tzinfo=timezone.utc)

# Fetch dataset at version timestamp
dataset_at_version = langfuse.get_dataset(
    name="my-dataset",
    version=version_timestamp
)

# Fetch latest version
dataset_latest = langfuse.get_dataset(name="my-dataset")
import { LangfuseClient } from "@langfuse/client";

const langfuse = new LangfuseClient();

// Capture the timestamp (use item's createdAt)
const versionTimestamp = new Date("2025-12-15T06:30:00").toISOString();

// Fetch dataset at version timestamp
const datasetAtVersion = await langfuse.dataset.get("my-dataset", {
  version: versionTimestamp
});

// Fetch latest version
const datasetLatest = await langfuse.dataset.get("my-dataset");
你可以通过导航到 Datasets → 选择数据集 → Items 标签页 → 切换 Version 视图 来查看所有数据集版本。
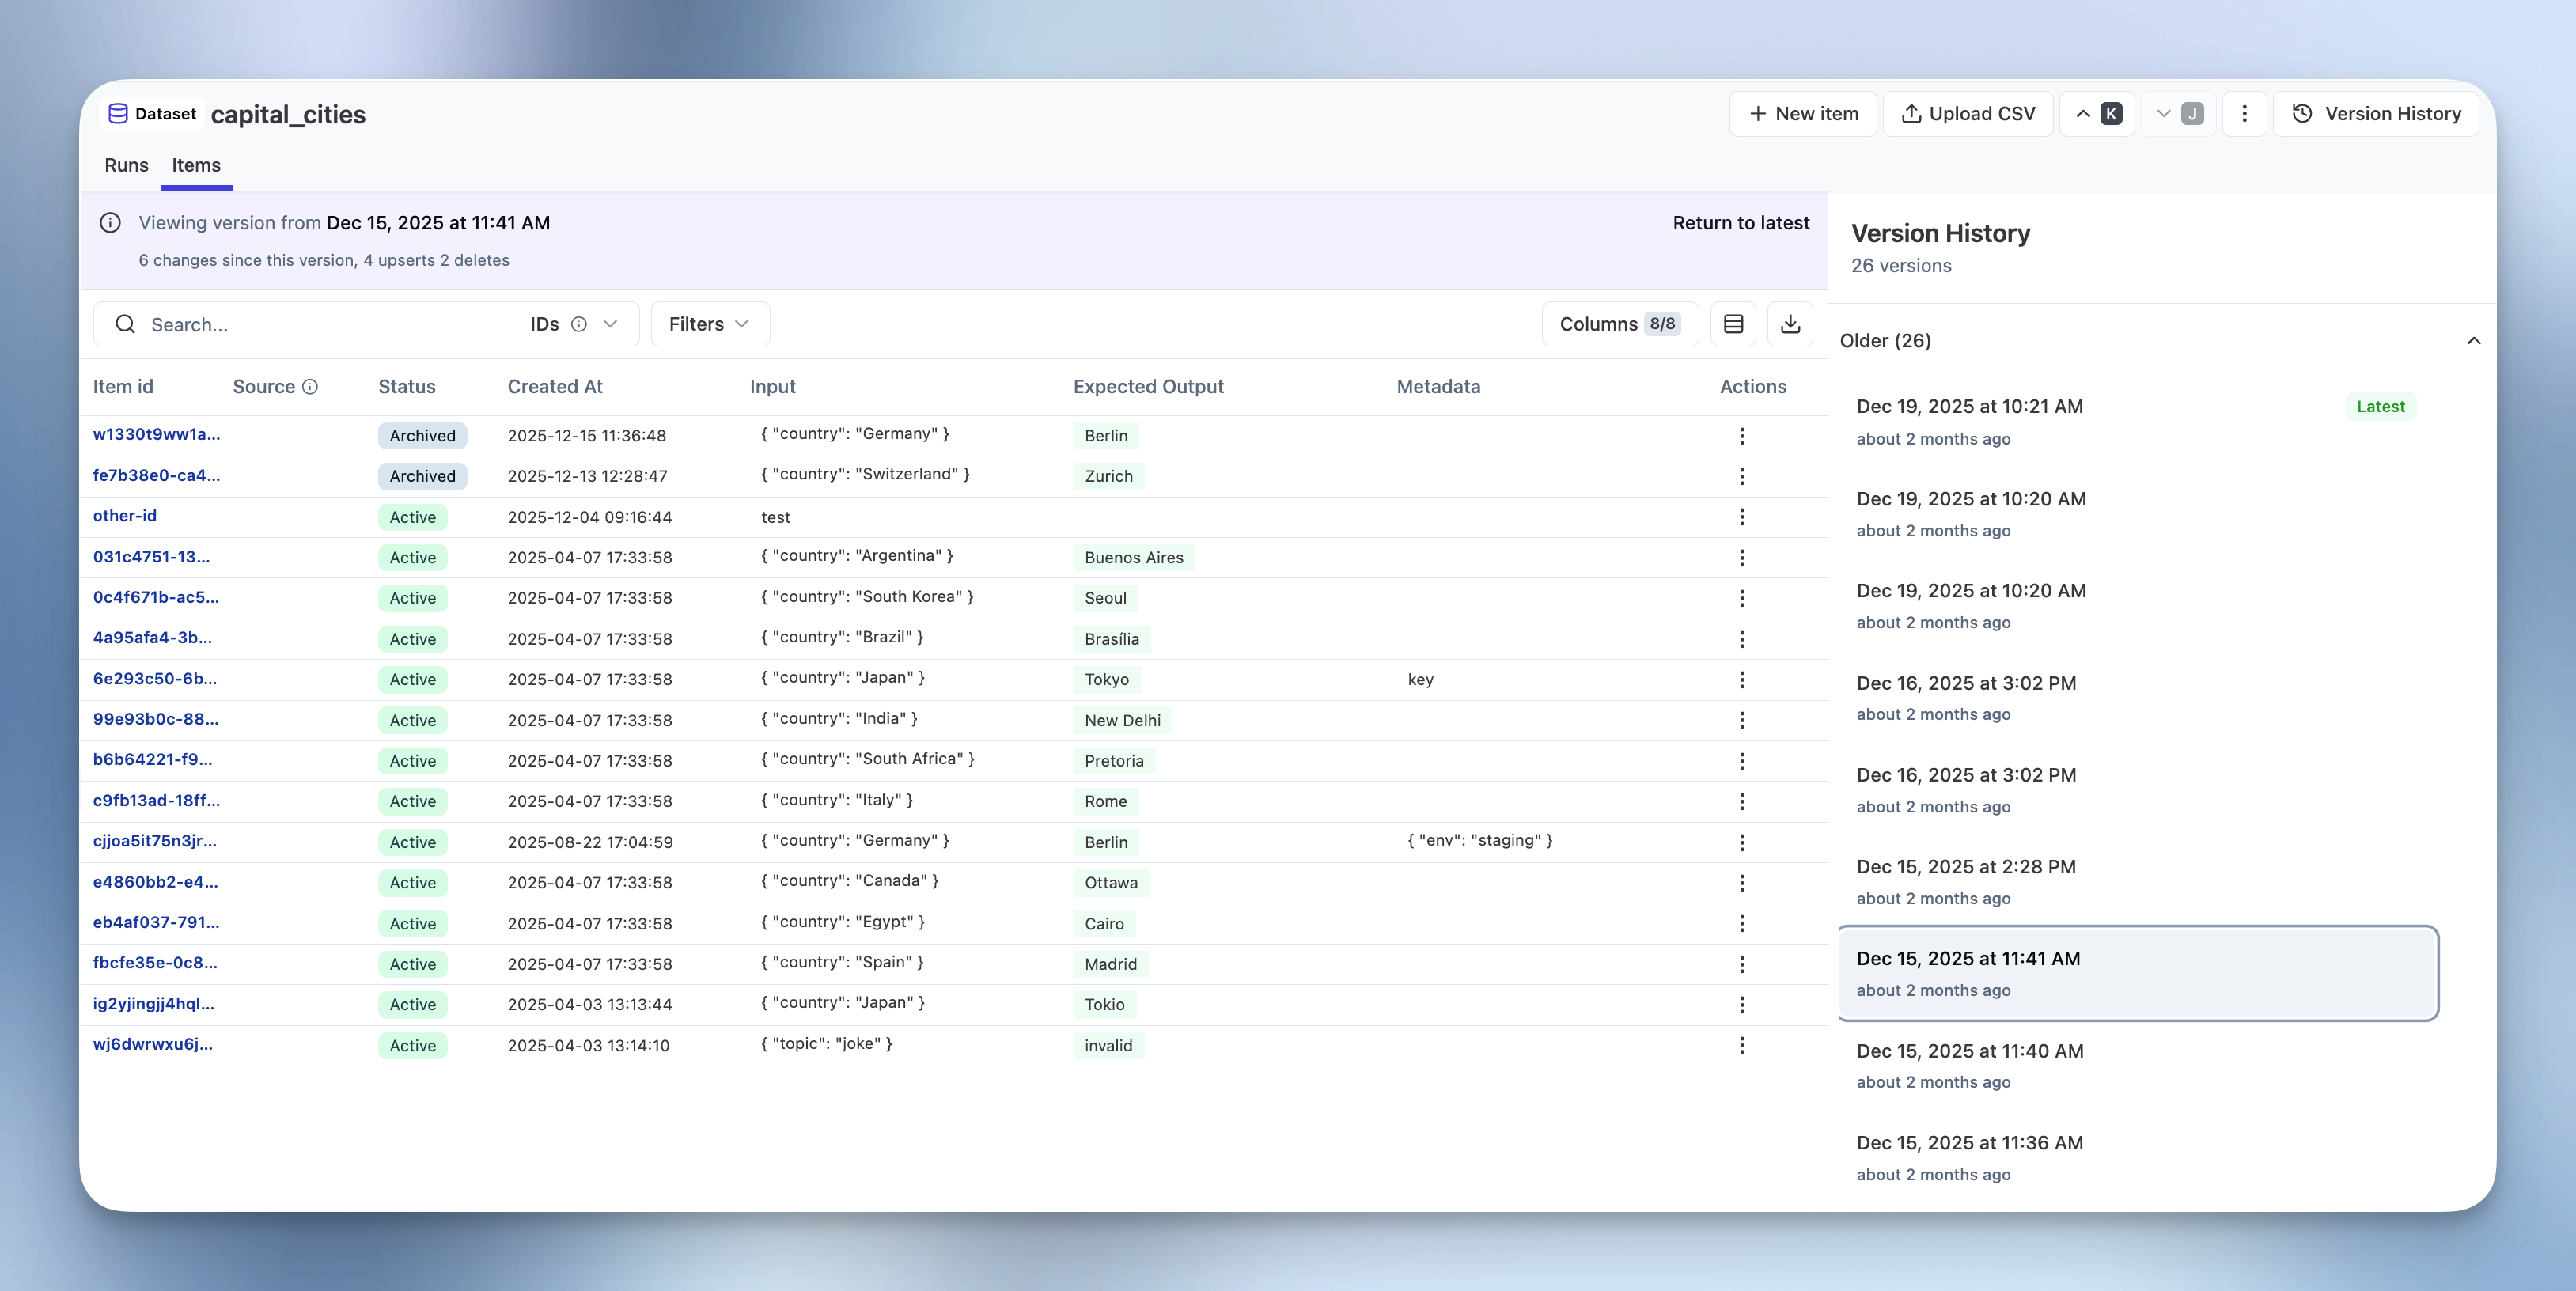
在版本化数据集上运行实验
你可以直接在版本化数据集上运行实验。这对于对比模型在不同数据集版本上的表现,或使用某个特定时间点的精确数据集状态复现实验结果非常有用。
from datetime import timedelta
import time
from langfuse import Langfuse

langfuse = Langfuse()

version_timestamp = datetime(2025, 12, 15, 6, 30, 0, tzinfo=timezone.utc)

# Fetch versioned dataset
versioned_dataset = langfuse.get_dataset("qa-dataset", version=version_timestamp)

# Run experiment on the versioned dataset
def my_llm_application(*, item, **kwargs):
    # Your LLM application logic here
    # For this example, we'll just return the expected output
    return item.expected_output

result = versioned_dataset.run_experiment(
    name="Baseline Experiment v1",
    description="Running on dataset v1",
    task=my_llm_application
)
import { LangfuseClient } from "@langfuse/client";

const langfuse = new LangfuseClient();

// Capture the version timestamp
const versionTimestamp = new Date("2025-12-15T06:30:00").toISOString();

// Fetch versioned dataset
const versionedDataset = await langfuse.dataset.get("qa-dataset", {
  version: versionTimestamp
});
// Run experiment on the versioned dataset
const result = await versionedDataset.runExperiment({
  name: "Baseline Experiment v1",
  description: "Running on dataset v1",
  task: async (item) => {
    // Your LLM application logic here
    // For this example, we'll just return the expected output
    return item.expectedOutput;
  }
});
在 UI 中,运行实验时可以选择特定的数据集版本:
- 导航到 Experiments → Run Experiment
- 在 Dataset Selection 步骤中选择你的数据集
- 从 Dataset Version 下拉框中选择一个版本
- 下拉框显示可用的版本时间戳
- 实验将针对该特定时间点的数据集状态运行
- 如果未选择版本,实验将针对最新版本运行
这种方式确保可复现性,让你能够:
- 即使条目已被更新或删除,也能在历史数据集版本上重新运行实验
- 对比数据集变更前后的模型表现
- 保持实验一致性,精确复现之前运行的结果
- 针对相同的基线数据集版本测试改进
Schema 强制校验
你可以选择为数据集添加 JSON Schema 校验,确保所有数据集条目符合定义的结构。这有助于保持数据质量、尽早发现错误,并确保团队间的一致性。
你可以在创建或更新数据集时,为 input 和/或 expectedOutput 字段定义 JSON schema。设置后,所有数据集条目都会自动与这些 schema 校验。有效的条目被接受,无效的条目被拒绝,并附带显示校验问题的详细错误信息。
langfuse.create_dataset(
    name="qa-conversations",
    input_schema={
        "type": "object",
        "properties": {
            "messages": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "role": {"type": "string", "enum": ["user", "assistant", "system"]},
                        "content": {"type": "string"}
                    },
                    "required": ["role", "content"]
                }
            }
        },
        "required": ["messages"]
    },
    expected_output_schema={
        "type": "object",
        "properties": {"response": {"type": "string"}},
        "required": ["response"]
    }
)
await langfuse.createDataset({
  name: "qa-conversations",
  inputSchema: {
    type: "object",
    properties: {
      messages: {
        type: "array",
        items: {
          type: "object",
          properties: {
            role: { type: "string", enum: ["user", "assistant", "system"] },
            content: { type: "string" }
          },
          required: ["role", "content"]
        }
      }
    },
    required: ["messages"]
  },
  expectedOutputSchema: {
    type: "object",
    properties: { response: { type: "string" } },
    required: ["response"]
  }
});
导航到 Datasets → New Dataset 或编辑现有数据集 → 展开 Schema Validation 部分 → 添加你的 JSON schema → 点击 Save。
创建合成数据集
通常,你想创建合成示例来测试应用,以便为数据集做冷启动。LLM 擅长通过提示生成常见问题/任务来产生这些示例。
要开始使用,请查看这个 cookbook,了解如何生成合成数据集的示例。
从生产数据创建条目
一个常见的工作流是:选择应用表现未达预期的生产 traces,然后让专家添加预期输出,以便在相同数据上测试应用的新版本。
langfuse.create_dataset_item(
    dataset_name="<dataset_name>",
    input={ "text": "hello world" },
    expected_output={ "text": "hello world" },
    # link to a trace
    source_trace_id="<trace_id>",
    # optional: link to a specific span, event, or generation
    source_observation_id="<observation_id>"
)
import { LangfuseClient } from "@langfuse/client";

const langfuse = new LangfuseClient();

await langfuse.dataset.createItem({
  datasetName: "<dataset_name>",
  input: { text: "hello world" },
  expectedOutput: { text: "hello world" },
  // link to a trace
  sourceTraceId: "<trace_id>",
  // optional: link to a specific span, event, or generation
  sourceObservationId: "<observation_id>",
});
在 UI 中,在生产 trace 的任意 observation(span、event、generation)上使用 + Add to dataset。
批量添加 observations 到数据集
你可以直接从 observations 表批量添加多个 observations 到数据集。这对于从生产数据快速构建测试数据集非常有用。
字段映射系统让你能够控制 observation 数据如何转换为数据集条目。你可以原样使用整个字段(例如把完整的 observation input 映射到数据集条目 input)、使用 JSON path 表达式提取特定值,或从多个字段构建自定义对象。
- 导航到 Observations 表
- 使用过滤器找到相关 observations
- 使用复选框选择 observations
- 点击 Actions → Add to dataset
- 选择创建新数据集或选择现有数据集
- 配置字段映射,控制 observation 数据如何映射到数据集条目字段
- 预览映射并确认
批量操作在后台运行,支持部分成功。如果某些 observations 未通过数据集 schema 校验,有效条目仍会被添加,错误会被记录下来供审阅。你可以在 Settings → Batch Actions 中监控进度。
编辑/归档数据集条目
你可以编辑或归档数据集条目。归档条目会将其从未来的实验运行中移除。
你可以通过提供要更新的条目的 id 来 upsert 条目。
langfuse.create_dataset_item(
    dataset_name="<dataset_name>",
    id="<item_id>",
    # example: update status to "ARCHIVED"
    status="ARCHIVED"
)
你可以通过提供要更新的条目的 id 来 upsert 条目。
import { LangfuseClient } from "@langfuse/client";

const langfuse = new LangfuseClient();

await langfuse.dataset.createItem({
  datasetName: "<dataset_name>",
  id: "<item_id>",
  // example: update status to "ARCHIVED"
  status: "ARCHIVED",
});
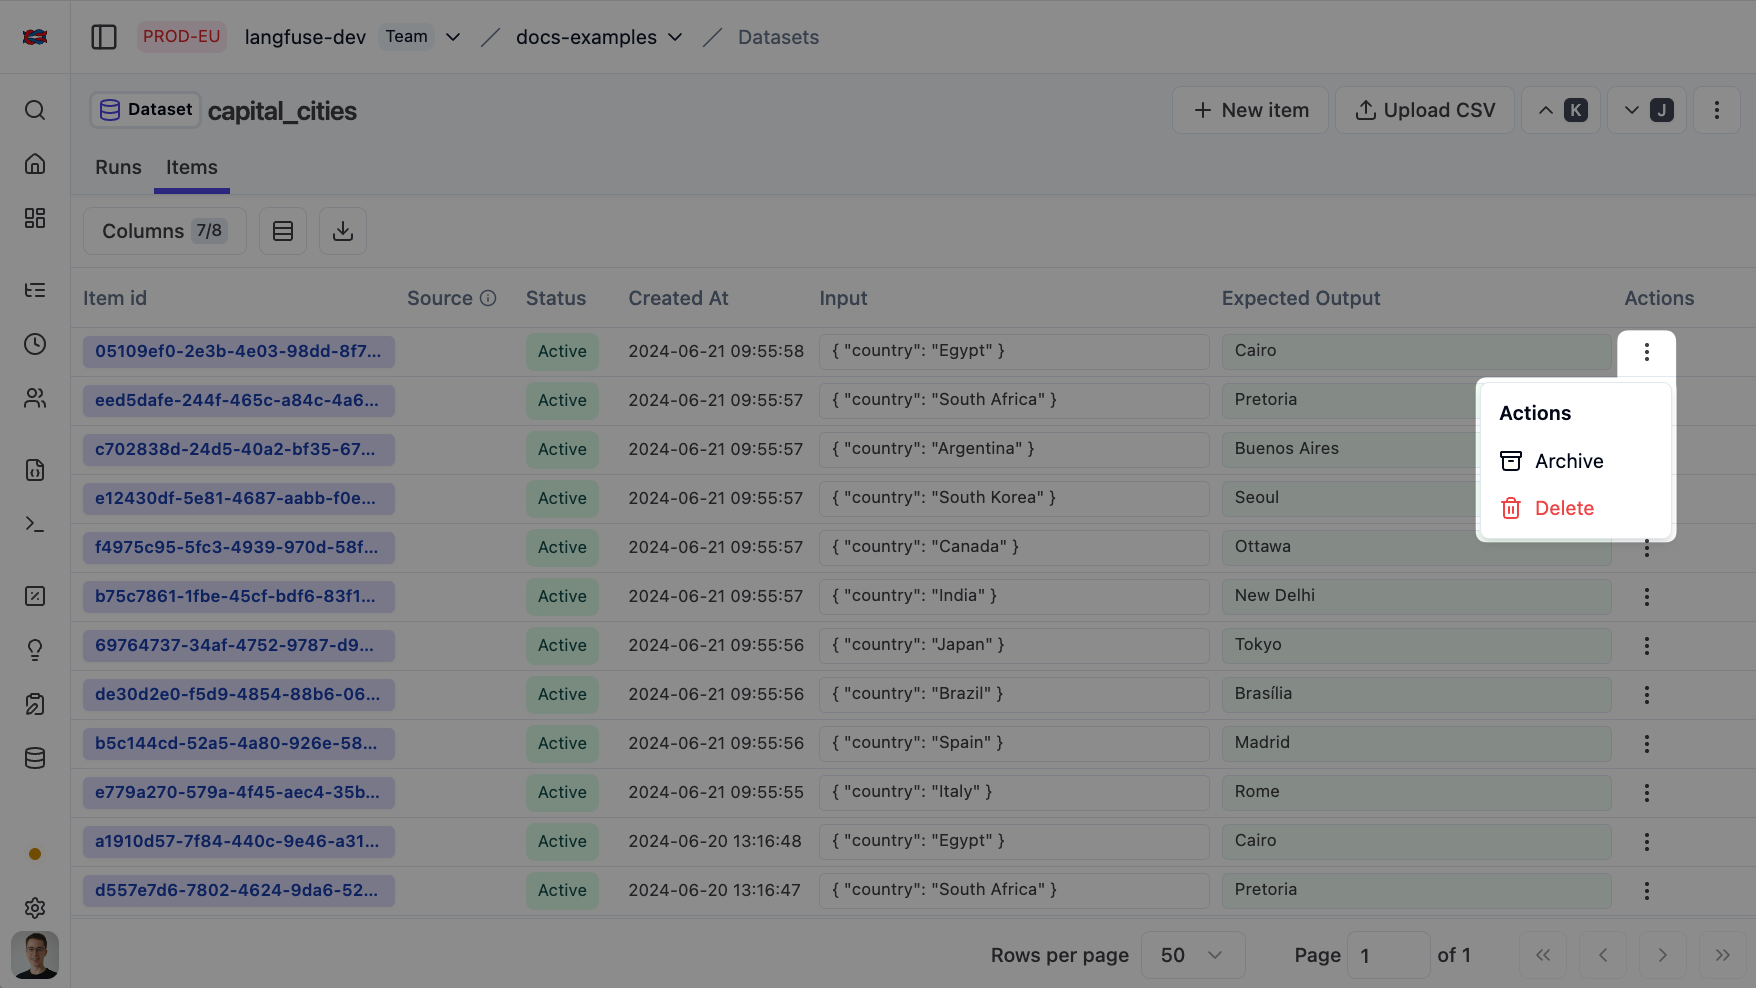
在 UI 中,你可以点击条目 id 来编辑条目。要归档或删除条目,点击条目旁边的点,选择 Archive 或 Delete。
数据集运行(Dataset runs)
创建数据集后,你可以基于它测试和评估你的应用。
了解更多关于实验数据模型的内容。